Faut-il entraîner sa propre IA pour son entreprise ?
Dans la plupart des PME, la question n’est pas de créer un modèle de zéro. Elle consiste à choisir le bon niveau de personnalisation : bonnes instructions, documents accessibles, recherche connectée, fine-tuning ou entraînement complet.
Une entreprise peut vouloir une IA qui connaît ses produits, respecte son vocabulaire et applique ses règles internes.
La première réaction consiste parfois à parler d’entraînement personnalisé. Pourtant, ce mot recouvre plusieurs réalités très différentes.
Donner un document à une IA n’est pas l’entraîner. Ajouter une consigne n’est pas modifier son modèle. Connecter une base documentaire n’a pas le même effet qu’un fine-tuning.
Pour faire le bon choix, partez du résultat attendu.
Les cinq niveaux de personnalisation
Niveau 1 : utiliser un modèle existant
Vous utilisez un modèle généraliste avec les fonctionnalités disponibles dans le produit choisi.
C’est le bon point de départ lorsque vous voulez :
- rédiger ou reformuler un texte ;
- résumer un document ;
- préparer une réunion ;
- analyser un tableau ;
- produire des idées ;
- traduire ou classer du contenu.
L’entreprise doit surtout cadrer les usages, les données envoyées et la validation humaine.
Niveau 2 : écrire de meilleures instructions
Vous ajoutez un rôle, un format de réponse, des règles et des exemples.
Par exemple :
Vous êtes chargé de préparer une première version de réponse à une demande client. Utilisez un ton professionnel. Ne promettez jamais un délai qui n’est pas présent dans les données. Signalez les informations manquantes et laissez la validation finale au responsable support.
Cette méthode peut améliorer fortement la qualité lorsque le problème vient d’une demande trop vague.
Elle ne permet toutefois pas à l’IA de connaître automatiquement toute la documentation de l’entreprise.
Niveau 3 : utiliser une recherche sur vos documents
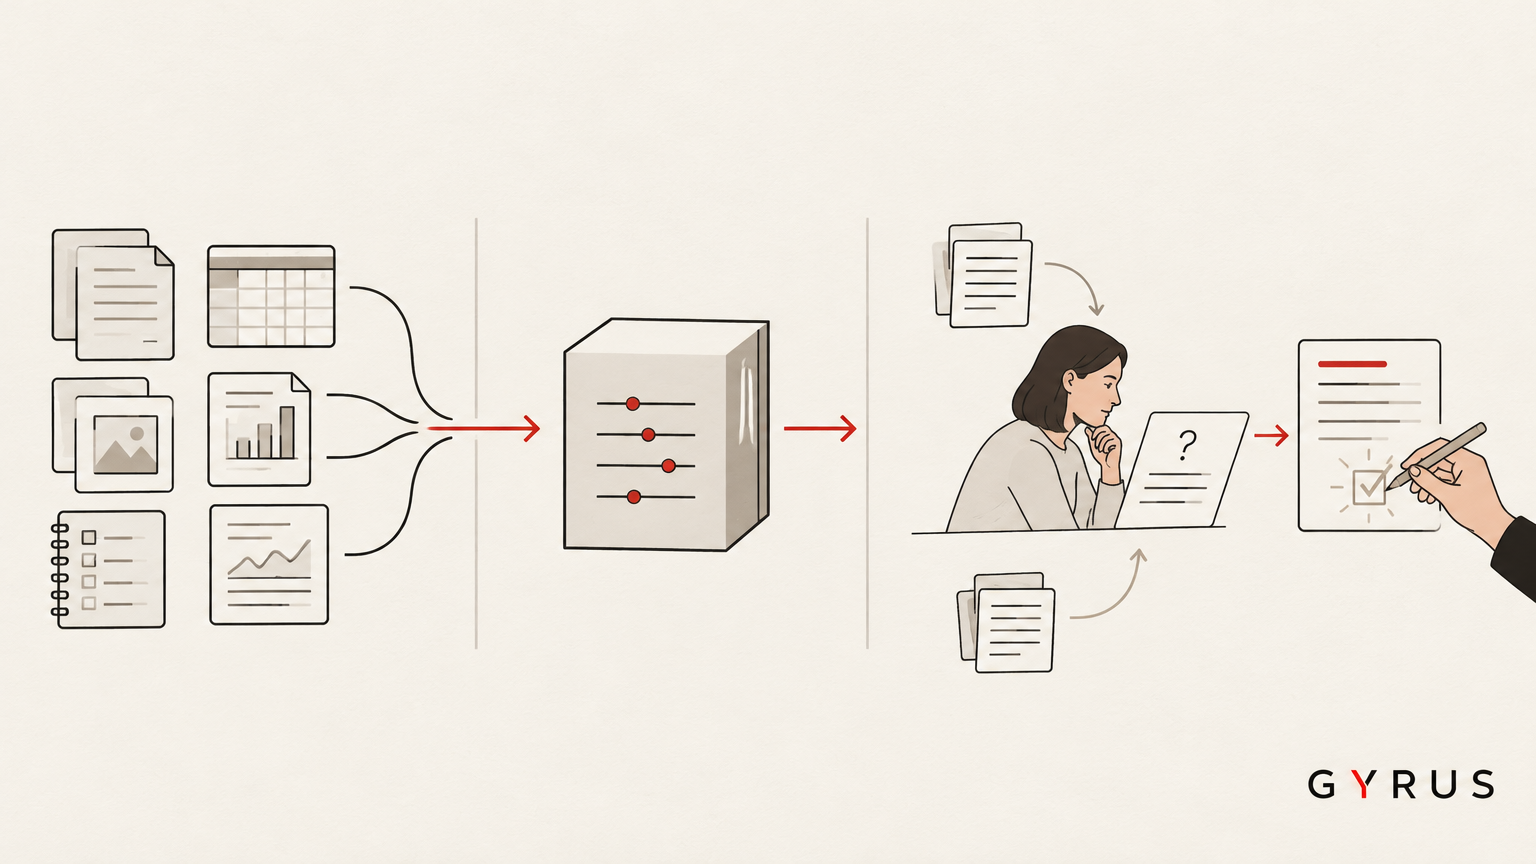
Le modèle reste généraliste, mais un système recherche des passages pertinents dans vos documents et les transmet à l’IA au moment de la réponse.
Cette approche est souvent appelée RAG, pour Retrieval-Augmented Generation.
Le fonctionnement est généralement le suivant :
- vos documents sont découpés et indexés ;
- la question de l’utilisateur est transformée en requête ;
- le système retrouve les passages les plus proches ;
- ces passages sont ajoutés au contexte ;
- le modèle rédige une réponse à partir des éléments récupérés.
Le RAG est adapté lorsque l’information change régulièrement ou doit rester sous le contrôle de l’entreprise.
Il peut servir à interroger :
- une base de procédures ;
- un catalogue produit ;
- une documentation technique ;
- une base de contrats ;
- un espace de support ;
- des comptes rendus internes.
Les documentations d’Anthropic montrent par exemple comment connecter un modèle à des résultats de recherche ou à une base de connaissances afin de fournir un contexte vérifiable.
Niveau 4 : faire un fine-tuning
Le fine-tuning consiste à ajuster un modèle existant à partir d’exemples spécifiques.
Il peut être utile lorsque vous voulez améliorer :
- un format de sortie répétitif ;
- un style rédactionnel ;
- une classification ;
- une structure de réponse ;
- une terminologie métier ;
- un comportement sur une tâche bien définie.
Il ne remplace pas toujours une base documentaire.
Si vos règles changent chaque semaine, il peut être plus simple de les conserver dans des sources consultables plutôt que de relancer régulièrement un entraînement.
Niveau 5 : entraîner un modèle complet
Entraîner un modèle de zéro demande des volumes de données, des compétences techniques, des capacités de calcul, une gouvernance et un budget importants.
Cette option peut se justifier pour un acteur qui :
- possède un volume de données très spécifique ;
- doit contrôler toute la chaîne technique ;
- a des exigences fortes de souveraineté ou de déploiement ;
- travaille sur une capacité absente des modèles existants ;
- dispose d’une équipe de recherche et d’ingénierie spécialisée.
Pour une PME qui veut simplement interroger ses procédures ou préparer ses devis, ce n’est généralement pas la première étape à envisager.
Quel problème voulez-vous vraiment résoudre ?
Le bon choix dépend du problème.
| Besoin | Première option à tester |
|---|---|
| Améliorer le style des réponses | Instructions et exemples |
| Répondre à partir de procédures internes | RAG ou recherche documentaire |
| Produire toujours le même format | Instructions structurées ou fine-tuning |
| Classer des demandes | Modèle existant, règles et évaluation |
| Gérer des données très sensibles | Architecture, droits et contrat avant technologie |
| Réduire les erreurs factuelles | Sources, recherche, citations et validation |
| Créer une capacité scientifique spécifique | Étude technique avant décision |
Commencez par le cas d’usage, pas par le nom de la technologie.
Entraîner le modèle ne corrige pas une mauvaise donnée
Une IA personnalisée ne devient pas fiable par magie.
Si vos documents sont contradictoires, incomplets ou obsolètes, le système risque d’apprendre ou de restituer ces défauts.
Avant toute personnalisation, vérifiez :
- la qualité des sources ;
- la date de mise à jour ;
- les doublons ;
- les documents contradictoires ;
- les règles abandonnées ;
- les droits d’accès ;
- le niveau de confidentialité ;
- la personne responsable de chaque source.
Une base documentaire mal tenue peut dégrader un système RAG comme un mauvais jeu de données peut dégrader un modèle entraîné.
RAG ou fine-tuning : quelle différence ?
La distinction peut se résumer ainsi :
- RAG : le modèle consulte des informations au moment de répondre.
- Fine-tuning : le modèle est ajusté à partir d’exemples pour modifier son comportement.
Le RAG est souvent préférable lorsque vous devez fournir des informations à jour et citer les sources.
Le fine-tuning peut être pertinent lorsque vous cherchez surtout un format, un style ou un comportement stable.
Les deux approches peuvent être combinées, mais elles ne répondent pas au même problème.
Les cinq questions à poser avant de personnaliser
1. L’information change-t-elle souvent ?
Si oui, favorisez une source consultable et mise à jour. Un entraînement ponctuel risque de devenir obsolète.
2. Le problème vient-il du modèle ou de vos processus ?
Un modèle ne réparera pas automatiquement une procédure confuse, une nomenclature instable ou une validation inexistante.
3. Quelle erreur pouvez-vous accepter ?
Une IA qui prépare un brouillon n’a pas le même niveau d’exigence qu’une IA qui déclenche un paiement ou modifie un dossier client.
4. Qui vérifie les données ?
Une personne doit être responsable des sources, des mises à jour et des règles d’accès.
5. Comment mesurez-vous l’amélioration ?
Définissez quelques cas de test avant de personnaliser. Sinon, vous ne saurez pas si le système est réellement meilleur.
Le plan de décision pour une PME
Étape 1 : choisir un usage
Décrivez une tâche précise, avec un utilisateur et un livrable.
Étape 2 : rassembler les sources
Sélectionnez les documents utiles et retirez ceux qui sont obsolètes ou contradictoires.
Étape 3 : tester un modèle existant
Utilisez des instructions claires et quelques exemples représentatifs.
Étape 4 : mesurer les erreurs
Classez les problèmes : information absente, mauvaise source, format incorrect, interprétation erronée ou validation insuffisante.
Étape 5 : choisir le niveau de personnalisation
- Si le problème est la consigne, améliorez les instructions.
- Si le problème est l’accès à l’information, testez un RAG.
- Si le problème est le format, étudiez un fine-tuning.
- Si le besoin dépasse les modèles existants, lancez une étude technique.
Étape 6 : fixer la frontière humaine
Définissez ce que l’IA peut proposer et ce qu’un humain doit valider.
Les pièges à éviter
Confondre données internes et entraînement
Donner accès à un document dans le contexte ne signifie pas que le modèle a été entraîné sur ce document.
Entraîner avant de nettoyer
Un mauvais corpus produit un résultat difficile à corriger.
Choisir la solution la plus complexe
Une architecture sophistiquée peut augmenter les coûts, les délais et les risques sans améliorer le résultat attendu.
Oublier les droits d’accès
Un système capable de retrouver un document doit aussi respecter les permissions associées à ce document.
Ne pas prévoir de sortie
Vous devez pouvoir changer de fournisseur, récupérer vos données et interrompre l’usage si le résultat n’est pas satisfaisant.
La règle simple à retenir
Pour une PME, l’ordre de décision le plus raisonnable est souvent :
- cadrer l’usage ;
- améliorer les instructions ;
- structurer les sources ;
- tester une recherche documentaire ;
- mesurer ;
- envisager un fine-tuning ;
- étudier un entraînement spécifique seulement si le besoin le justifie.
L’IA avance vite. L’entreprise doit garder le cap sur le besoin métier, les données et la décision humaine.
Consultez aussi notre méthode pour intégrer l’IA dans une PME en 7 étapes et notre article sur le premier agent IA dans une PME.
Cadrer votre projet IA avec GYRUS
FAQ
Une PME doit-elle entraîner son propre modèle ?
Dans la plupart des cas, non. Il est préférable de commencer par un modèle existant, de bonnes instructions et des sources métier bien structurées.
Le RAG est-il un entraînement du modèle ?
Non. Le RAG ajoute des informations recherchées au contexte de la demande. Le modèle n’est pas nécessairement modifié.
Quand le fine-tuning devient-il pertinent ?
Il peut être utile lorsque vous cherchez à stabiliser un style, un format, une classification ou un comportement précis sur une tâche répétitive et bien évaluée.
Comment protéger les données de l’entreprise ?
Vérifiez les droits d’accès, les conditions contractuelles, la conservation des données, les sous-traitants, les environnements de test et les règles de validation. La personnalisation ne doit pas commencer avant ce cadrage.
Sources
- Google for Developers — LLMs: What’s a large language model?.
- Google for Developers — Fine-tuning, distillation, and prompt engineering.
- Anthropic — Search results and knowledge base tools.
- Anthropic — Embeddings.
- Veille IA GYRUS — La sécurité des agents se déplace hors du modèle, consultée le 21 octobre 2026.
Note de direction artistique
Thème : Nuit, pour exprimer la décision, le pilotage et la comparaison des options.
Rôle du rouge : Signaler le flux IA et le point de choix, pas toutes les branches.
Idée principale : Avant d’entraîner un modèle, il faut choisir le bon niveau de personnalisation.
Preuve identifiable : Modèle existant, instructions, RAG, fine-tuning et entraînement complet comparés.
Registre visuel : Photographie documentaire, pour montrer une équipe qui arbitre sur un tableau de travail réel.
Hypothèses et limites : Les coûts et performances varient selon les fournisseurs, les données et le cas d’usage ; l’article donne une méthode de décision, pas une recommandation de fournisseur.
À propos de l'auteur
Benjamin Gombeaud
Fondateur de GYRUS. Opérateur IA quotidien depuis 2022, utilisateur Dust.tt depuis 2025. Forme et déploie l'IA dans des PME françaises avec un seul principe : Parallel Intelligence — l'IA amplifie les humains, elle ne les remplace pas.
Voir le profil auteur →