Comment une IA est entraînée puis répond à votre question ?
Une IA générative ne réfléchit pas comme un humain. Elle a appris des régularités à partir de données, puis elle produit une réponse en fonction de votre demande, du contexte disponible et de ses paramètres. Comprendre ce cycle aide à mieux l’utiliser en entreprise.
Quand une équipe utilise ChatGPT, Claude ou un agent interne, une question revient souvent :
Comment la machine arrive-t-elle à produire une réponse qui semble comprendre ma demande ?
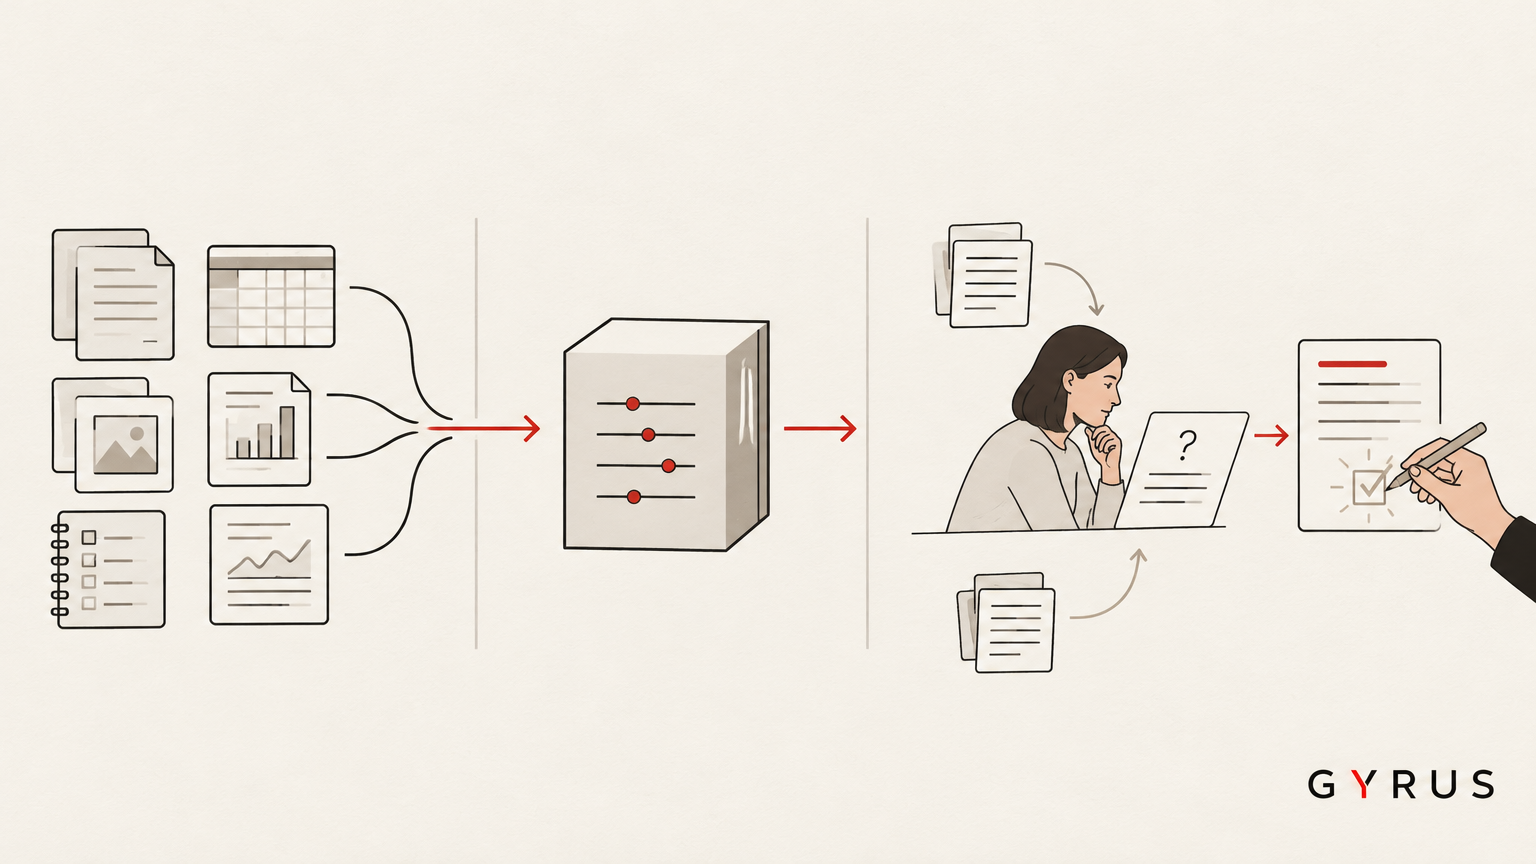
La réponse tient en deux grandes phases :
- l’entraînement, pendant lequel le modèle ajuste ses paramètres à partir de nombreux exemples ;
- l’inférence, pendant laquelle il utilise ces paramètres pour produire une réponse à une demande précise.
Entre les deux, il faut ajouter le contexte fourni à l’outil : votre question, les échanges précédents, les documents transmis ou les résultats d’une recherche.
Première étape : transformer les données en exemples exploitables
Un modèle de langage ne lit pas un document comme un salarié. Il traite des unités appelées tokens.
Un token peut correspondre à un mot, une partie de mot, un signe de ponctuation ou un groupe de caractères. Le découpage dépend du modèle et de la langue.
Par exemple, une phrase peut être transformée en une suite de tokens numériques. Le modèle travaille ensuite sur ces suites plutôt que sur des phrases « comprises » comme le ferait une personne.
Les données utilisées pour développer un modèle peuvent provenir de plusieurs sources : contenu public, jeux de données sous licence, données produites par des formateurs humains ou données générées pour l’entraînement. Les pratiques exactes dépendent du fournisseur et du modèle.
OpenAI décrit par exemple plusieurs étapes : préparation des données, pré-entraînement, post-entraînement, évaluation et amélioration continue. Ces étapes ne sont pas identiques pour tous les modèles.
Deuxième étape : apprendre à prédire la suite
Lors du pré-entraînement, le modèle reçoit une séquence incomplète et doit estimer ce qui vient ensuite.
Prenons une phrase simple :
Le commercial envoie le devis au…
Le modèle attribue des probabilités à plusieurs suites possibles : client, prospect, service comptable ou directeur. Il ne choisit pas parce qu’il connaît cette situation particulière. Il s’appuie sur les relations statistiques apprises dans de nombreux exemples.
Au début de l’entraînement, les prédictions sont très mauvaises. Le modèle ajuste progressivement ses paramètres pour réduire l’écart entre sa prédiction et le token attendu.
Ces paramètres sont souvent appelés poids. Ils représentent les réglages internes du réseau de neurones. Ils ne sont pas une bibliothèque de documents consultable comme un dossier partagé.
Ce que le modèle apprend réellement
Le modèle apprend des régularités :
- quels mots apparaissent souvent ensemble ;
- quelles structures correspondent à une question ;
- comment une phrase se construit ;
- quels formats suivent certaines consignes ;
- quelles relations existent entre des concepts présents dans les données.
Il ne stocke pas nécessairement une copie exacte de chaque phrase utilisée pendant l’entraînement. En revanche, un modèle peut parfois reproduire des éléments présents plusieurs fois dans ses données ou générer une information ressemblant à une donnée apprise.
Il faut donc éviter deux simplifications :
- « l’IA a mémorisé tout Internet » ;
- « l’IA ne conserve rien et ne peut jamais reproduire une information ».
La réalité dépend du modèle, des données, des méthodes d’entraînement et des protections mises en place.
Troisième étape : apprendre à suivre une instruction
Prédire la suite d’un texte ne suffit pas pour répondre utilement à un utilisateur.
Un modèle peut produire une phrase grammaticalement correcte sans respecter une consigne. Il faut donc une phase de post-entraînement.
Cette phase peut inclure :
- des exemples de réponses attendues ;
- des corrections humaines ;
- des comparaisons entre plusieurs réponses ;
- des règles de sécurité ;
- des tests de robustesse ;
- des évaluations automatisées et humaines.
OpenAI a notamment documenté des méthodes où des annotateurs rédigent ou classent des réponses, puis où le modèle est ajusté pour mieux suivre les préférences et les instructions humaines.
Cette phase améliore l’utilité du système. Elle ne garantit pas que toutes les réponses seront vraies.
Quatrième étape : votre question devient un contexte
Lorsque vous posez une question à une IA, elle reçoit généralement un ensemble de tokens :
- votre message ;
- les instructions du système ;
- une partie de l’historique de conversation ;
- des documents ajoutés ;
- des résultats de recherche ;
- parfois des sorties d’outils.
Cet ensemble constitue le contexte de la réponse.
Le modèle ne connaît pas nécessairement vos documents internes. Il ne peut utiliser que les informations qui lui sont transmises dans le contexte ou celles qui ont été intégrées dans le modèle lors d’un entraînement antérieur.
C’est une distinction essentielle pour les entreprises :
Utiliser une IA avec vos documents n’est pas la même chose qu’entraîner le modèle sur vos documents.
Cinquième étape : l’inférence produit la réponse
L’inférence est le moment où le modèle utilise ses paramètres et le contexte reçu pour générer une réponse.
Le modèle estime le token le plus probable, puis recommence avec le token ajouté au contexte. Il construit ainsi la réponse progressivement.
Schématiquement :
- le modèle reçoit la question ;
- il estime le prochain token ;
- il ajoute ce token à la séquence ;
- il estime le suivant ;
- il répète l’opération jusqu’à la fin de la réponse.
Le glossaire de Google consacré au machine learning définit l’inférence comme le processus qui consiste à utiliser un modèle entraîné pour générer une réponse.
Pourquoi deux réponses peuvent-elles être différentes ?
Plusieurs suites de tokens peuvent être plausibles. Le système peut donc sélectionner une réponse différente selon :
- la formulation de la question ;
- l’historique de la conversation ;
- le contexte fourni ;
- les réglages de génération ;
- la version du modèle ;
- les règles de sécurité ;
- les outils appelés au moment de la réponse.
Une réponse différente ne signifie pas nécessairement que le modèle « change d’avis ». Elle peut simplement résulter d’une autre séquence de probabilités.
Pourquoi une IA peut-elle inventer une information ?
Le modèle est optimisé pour produire une suite cohérente et plausible. Il n’est pas automatiquement relié à une base de vérité qui vérifierait chaque phrase.
Il peut donc produire une réponse convaincante mais fausse lorsque :
- le contexte ne contient pas l’information ;
- la question est ambiguë ;
- le sujet est récent ;
- les données d’entraînement sont insuffisantes ;
- la demande exige une précision que le modèle ne peut pas garantir ;
- le modèle préfère compléter plutôt que reconnaître son incertitude.
Une réponse fluide n’est pas une preuve.
Ce que cela change pour une PME
Cette explication technique produit des décisions très concrètes.
Pour une tâche créative
Vous pouvez demander à l’IA de proposer plusieurs variantes, puis choisir celle qui correspond au contexte de l’entreprise.
Pour une tâche documentaire
Vous devez fournir les bonnes sources et demander à l’outil de signaler ce qu’il ne trouve pas.
Pour une décision métier
Vous devez conserver une validation humaine, surtout si la sortie influence un client, un salarié, un contrat ou une dépense.
Pour un agent connecté
Vous devez contrôler les outils et les données accessibles. Le modèle ne doit pas recevoir plus de droits que nécessaire.
Entraîner une IA ne veut pas dire lui apprendre une procédure en une phrase
Une entreprise peut vouloir qu’une IA « connaisse » ses règles internes. Plusieurs solutions existent :
- fournir les règles dans les instructions ;
- connecter une base documentaire ;
- utiliser une recherche avant la génération ;
- ajuster le modèle sur des exemples spécifiques ;
- développer ou entraîner un modèle spécialisé.
Ces options ne produisent pas le même résultat et ne demandent pas le même budget.
Dans la plupart des PME, la première étape consiste à clarifier l’usage, les sources et la validation attendue. Il est rarement utile de commencer par un entraînement complet.
Pour aller plus loin, consultez notre article sur le choix d’un modèle, d’un RAG ou d’un entraînement spécifique.
Une méthode simple pour utiliser l’IA sans la surestimer
Avant de faire confiance à une réponse, posez cinq questions :
- Quelles informations l’IA a-t-elle réellement reçues ?
- La demande était-elle suffisamment précise ?
- La réponse peut-elle être vérifiée rapidement ?
- Quelle conséquence aurait une erreur ?
- Qui garde la décision finale ?
Cette méthode résume le rôle de Parallel Intelligence : la machine prépare, reformule et accélère ; l’humain vérifie, décide et assume le résultat.
Identifier les bons usages de l’IA dans votre entreprise
FAQ
Une IA comprend-elle vraiment ce qu’elle écrit ?
Elle traite des relations entre des tokens et produit une séquence probable à partir de paramètres appris et d’un contexte. Cela peut donner une réponse très pertinente, mais ce fonctionnement n’est pas équivalent à la compréhension humaine.
Une IA connaît-elle automatiquement les documents de mon entreprise ?
Non. Elle doit recevoir ces documents dans le contexte, y accéder via une recherche ou avoir été entraînée selon un dispositif spécifique. Dans tous les cas, les droits d’accès et les données doivent être cadrés.
Pourquoi une IA affirme-t-elle parfois quelque chose de faux ?
Parce qu’elle peut produire une suite plausible sans disposer d’une information vérifiée. La fluidité de la réponse ne garantit pas sa fiabilité.
Est-ce que chaque question réentraîne le modèle ?
Non. Une conversation peut servir au contexte de la réponse sans modifier immédiatement les paramètres du modèle. L’utilisation éventuelle des données pour améliorer un service dépend du fournisseur, du produit, du contrat et des réglages choisis.
Sources
- OpenAI — How ChatGPT and our foundation models are developed.
- Google for Developers — Machine Learning Glossary.
- Google for Developers — Introduction to Large Language Models.
- OpenAI — Aligning language models to follow instructions.
- Veille IA GYRUS — La sécurité des agents se déplace hors du modèle
À propos de l'auteur
Benjamin Gombeaud
Fondateur de GYRUS. Opérateur IA quotidien depuis 2022, utilisateur Dust.tt depuis 2025. Forme et déploie l'IA dans des PME françaises avec un seul principe : Parallel Intelligence — l'IA amplifie les humains, elle ne les remplace pas.
Voir le profil auteur →